CSL JSON · RDF
Zotero
整個文獻庫搬過來;用 RDF 匯出還會連 PDF 一起建索引,AI 找得到內文。
Verital 是給研究生的桌面研究工作台。讀論文、寫論文、跑實驗、錄課堂,都在你自己的電腦上。AI 寫下的每一句,都連得回它讀過的那一行;每一個數字,都連得回跑出它的那一次實驗。連不回去的,它會直接告訴你。
論文、錄音、投影片、手寫、資料表、實驗紀錄、你自己的草稿,全部存在你的電腦上。AI 每回答一題,只拿那一題用得到的幾段,不會把整個資料夾送上雲端。
問它:達爾文在這一頁怎麼寫加拉巴哥的雀鳥?句子是它寫的,證據不是——每一句後面都掛著它讀過的那一段原文。
他寫雀鳥的種數與個體數「遠多於其他任何一科鳥類」[1];其中全黑個體所占的比例「極小」[2]。
[1] 達爾文,鳥類筆記(1836),第 72 頁,第 3–5 行 [2] 同頁,第 9–10 行點 [1],就回到 1836 年那本手稿的第 72 頁,被引用的三行亮著。對不上的句子會被擋下來,不會變成一條看起來很像真的參考文獻。
“Hence these Finches are in number of Species & individuals far preponderant over any other family of birds.”
原文依達爾文 1836 年鳥類筆記第 72 頁手稿轉寫。
改一個字、看一眼 PDF,截稿前一晚要來回幾百次。這裡是真的 LaTeX,不是近似的預覽:Tectonic 引擎放進 App 裡重新調過,四節的論文 0.3 秒出 PDF;Typst 只重畫你正在看的那幾塊。
\subsubsection{Scaled Dot-Product Attention}
We compute the attention function on a
set of queries simultaneously:
\begin{equation}
  \mathrm{Attention}(Q,K,V) =
  \mathrm{softmax}\left(\frac{QK^{T}}{\sqrt{d_k}}\right)V
\end{equation}
We compute the attention function on a set of queries simultaneously:
The two most commonly used attention functions are additive attention and dot-product attention.
同一台 Apple 晶片 Mac 實測,2026 年 8–9 月。
拼圖大綱先排好每一頁要講什麼;生成的每一頁照設計系統重新排版,不是套模板。論文裡的圖會被切出來放上去,示意圖畫成可以改的圖形。
第一步是拼圖:測試版讀完論文排出這 7 段、12 片,另外 2 片放在片庫。可以搬片、加格子,或什麼都不動就照它生成。
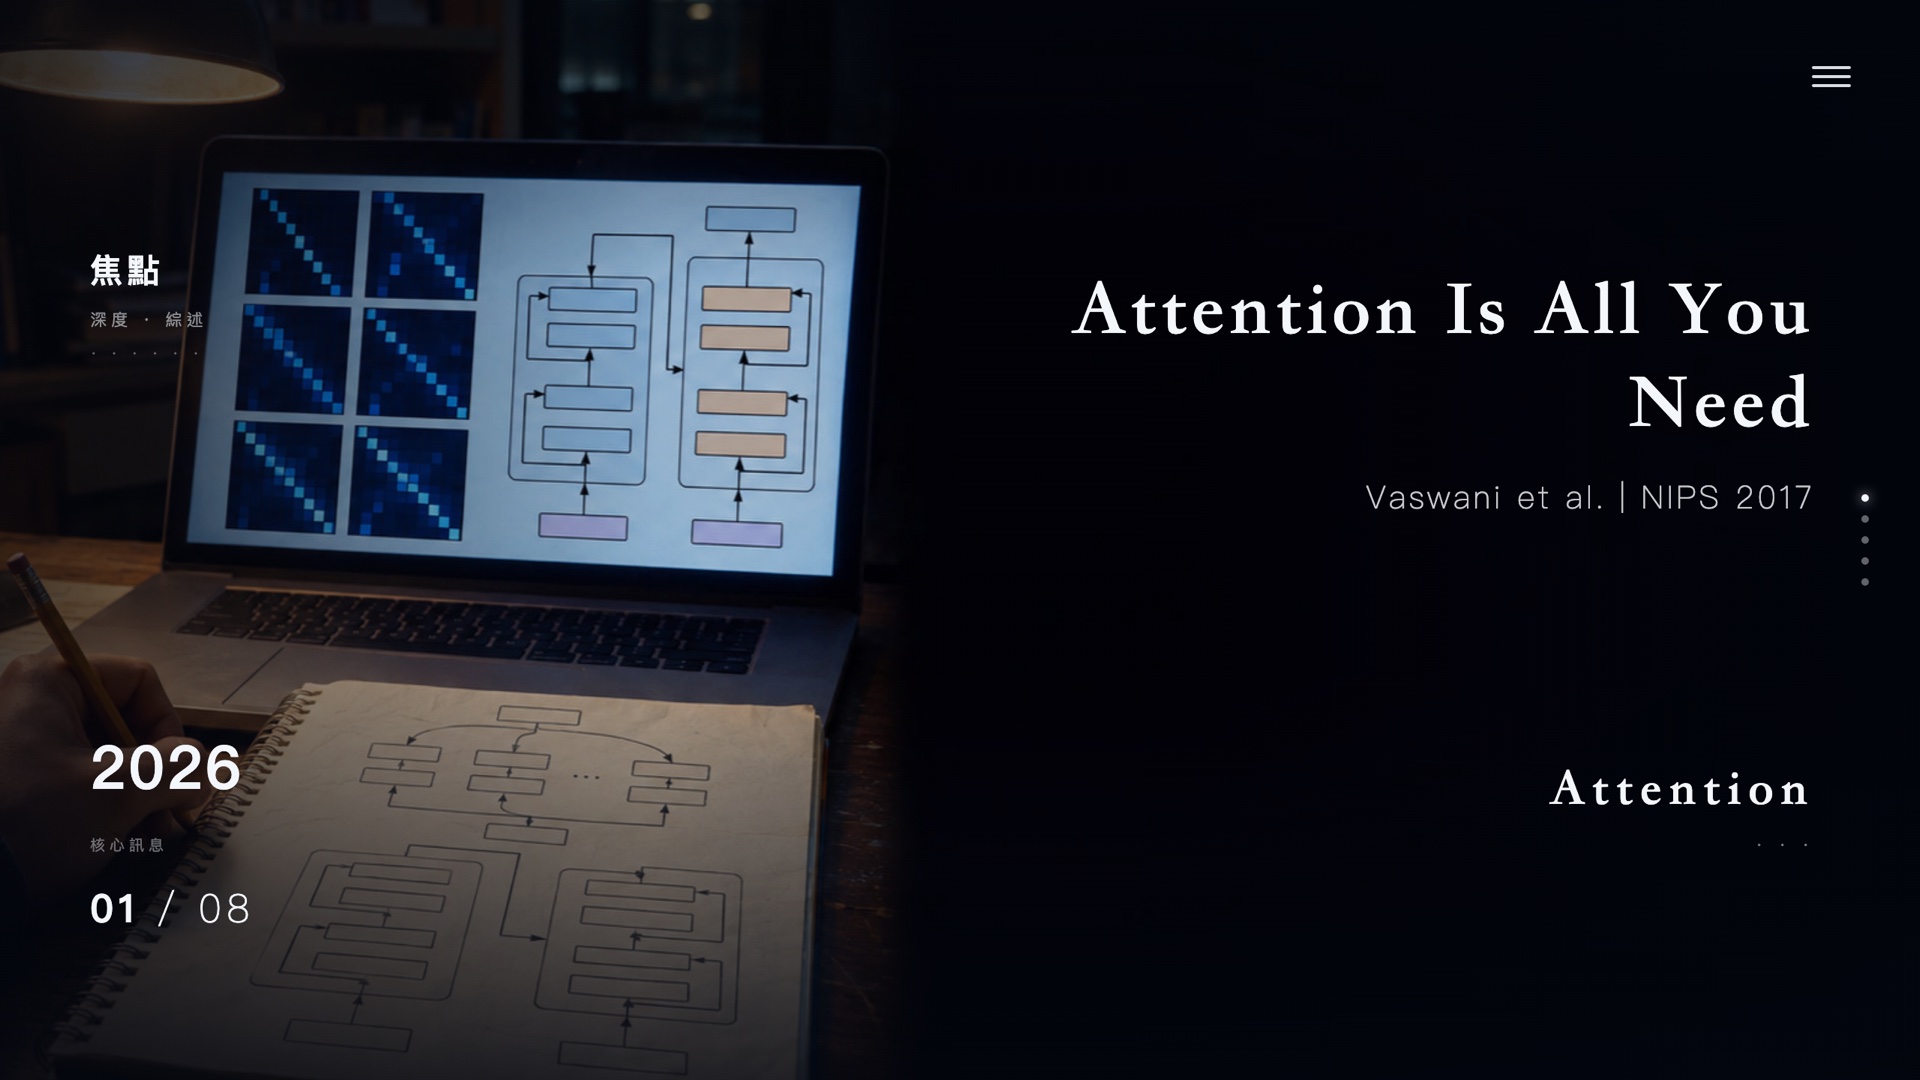
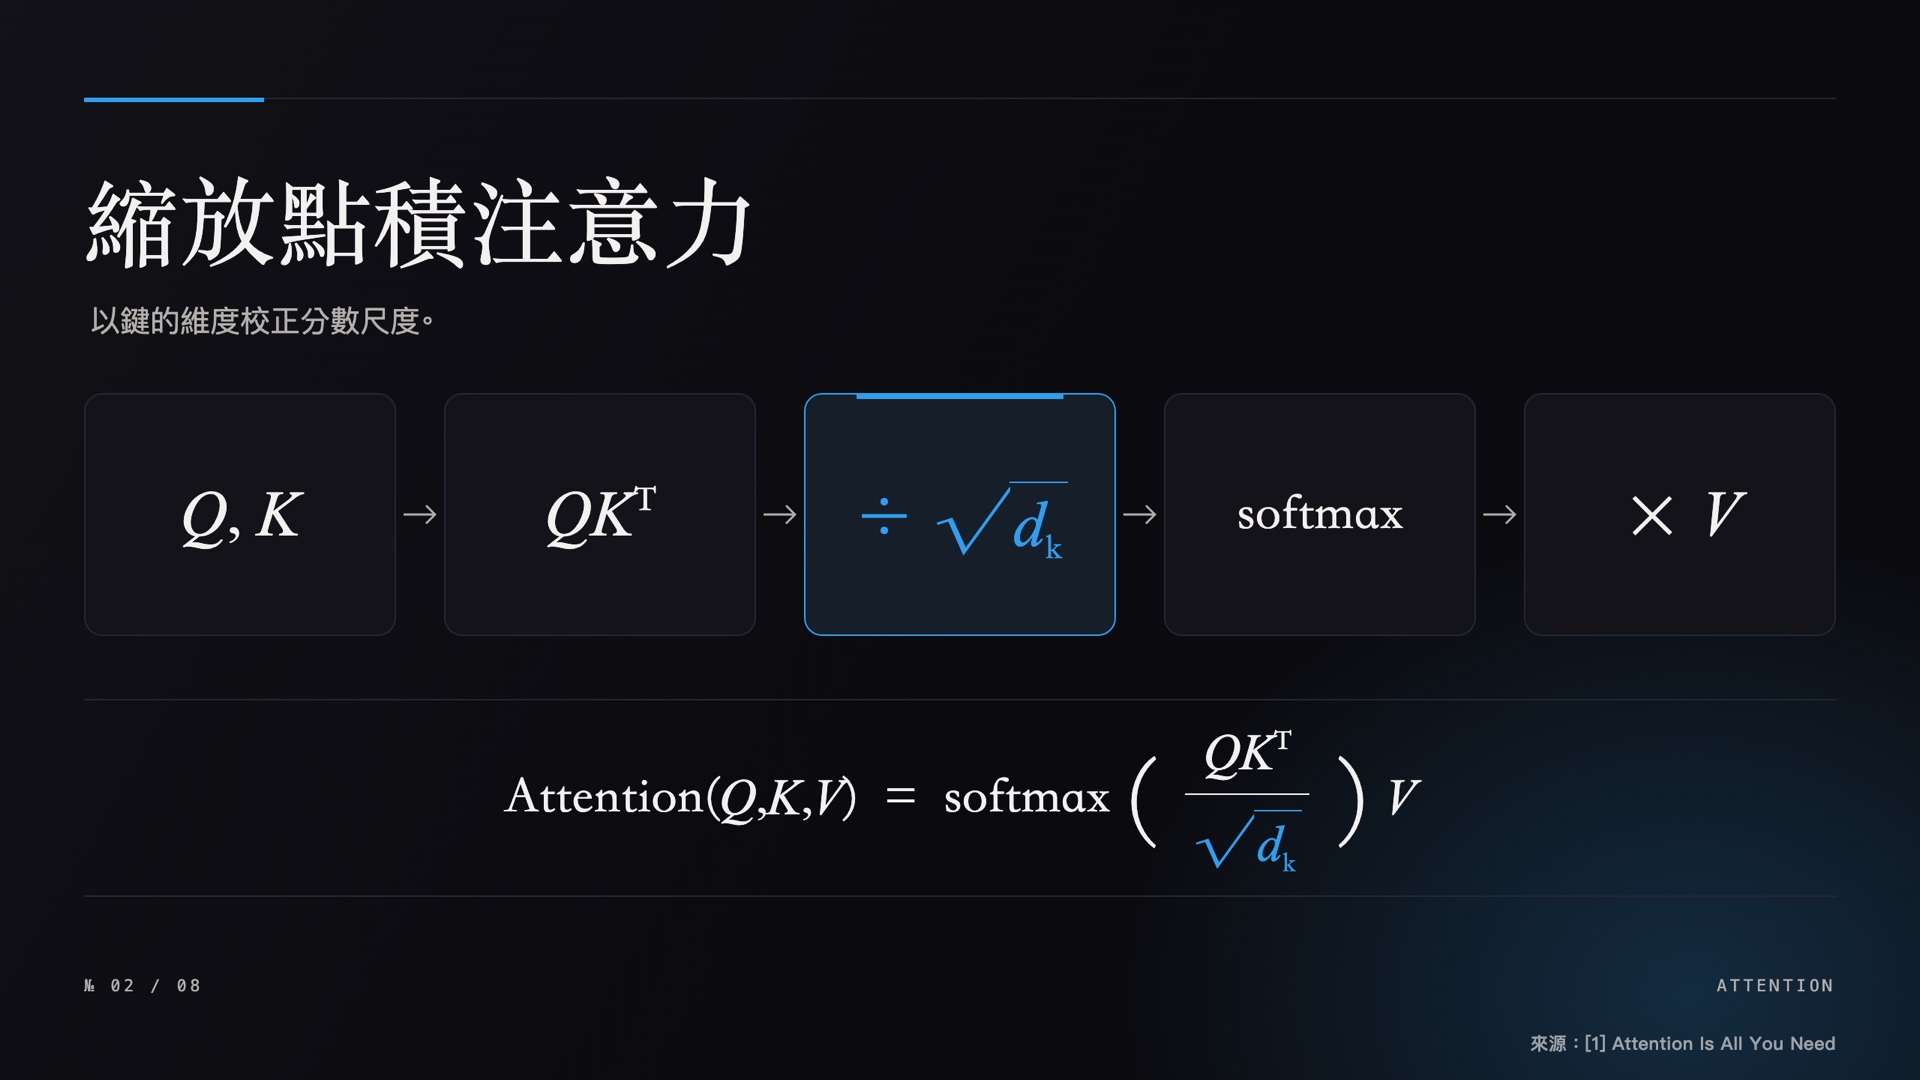
第二步,照架構一頁一頁設計:測試版用「Verital 官網」設計系統生成封面與內頁,第二頁用「重做本頁」交代了「字少、圖大」。沒有手動修圖,點一張可以放大。
說這一頁哪裡不對,只重排這一頁,講者備註和轉場都留著。
長條、折線、盒鬚圖都從你指定的那張表算出來;表一改,圖跟著改。
PDF 頁面上的圖和表會被偵測出來、用高解析度切下,放到講到它的那一頁。
在 App 裡帶講者備註放映,或匯出 PowerPoint、PDF。
用一句話描述腎元怎麼過濾、突觸怎麼傳遞;或直接丟一篇論文,它讀完方法再畫出那篇的機制圖。畫風照學科挑——教科書水彩、銅版雕刻、立體剖面、等角技術圖。每個標籤都會變成可以改的文字,匯出成 SVG 或 PowerPoint 之後還是能改。
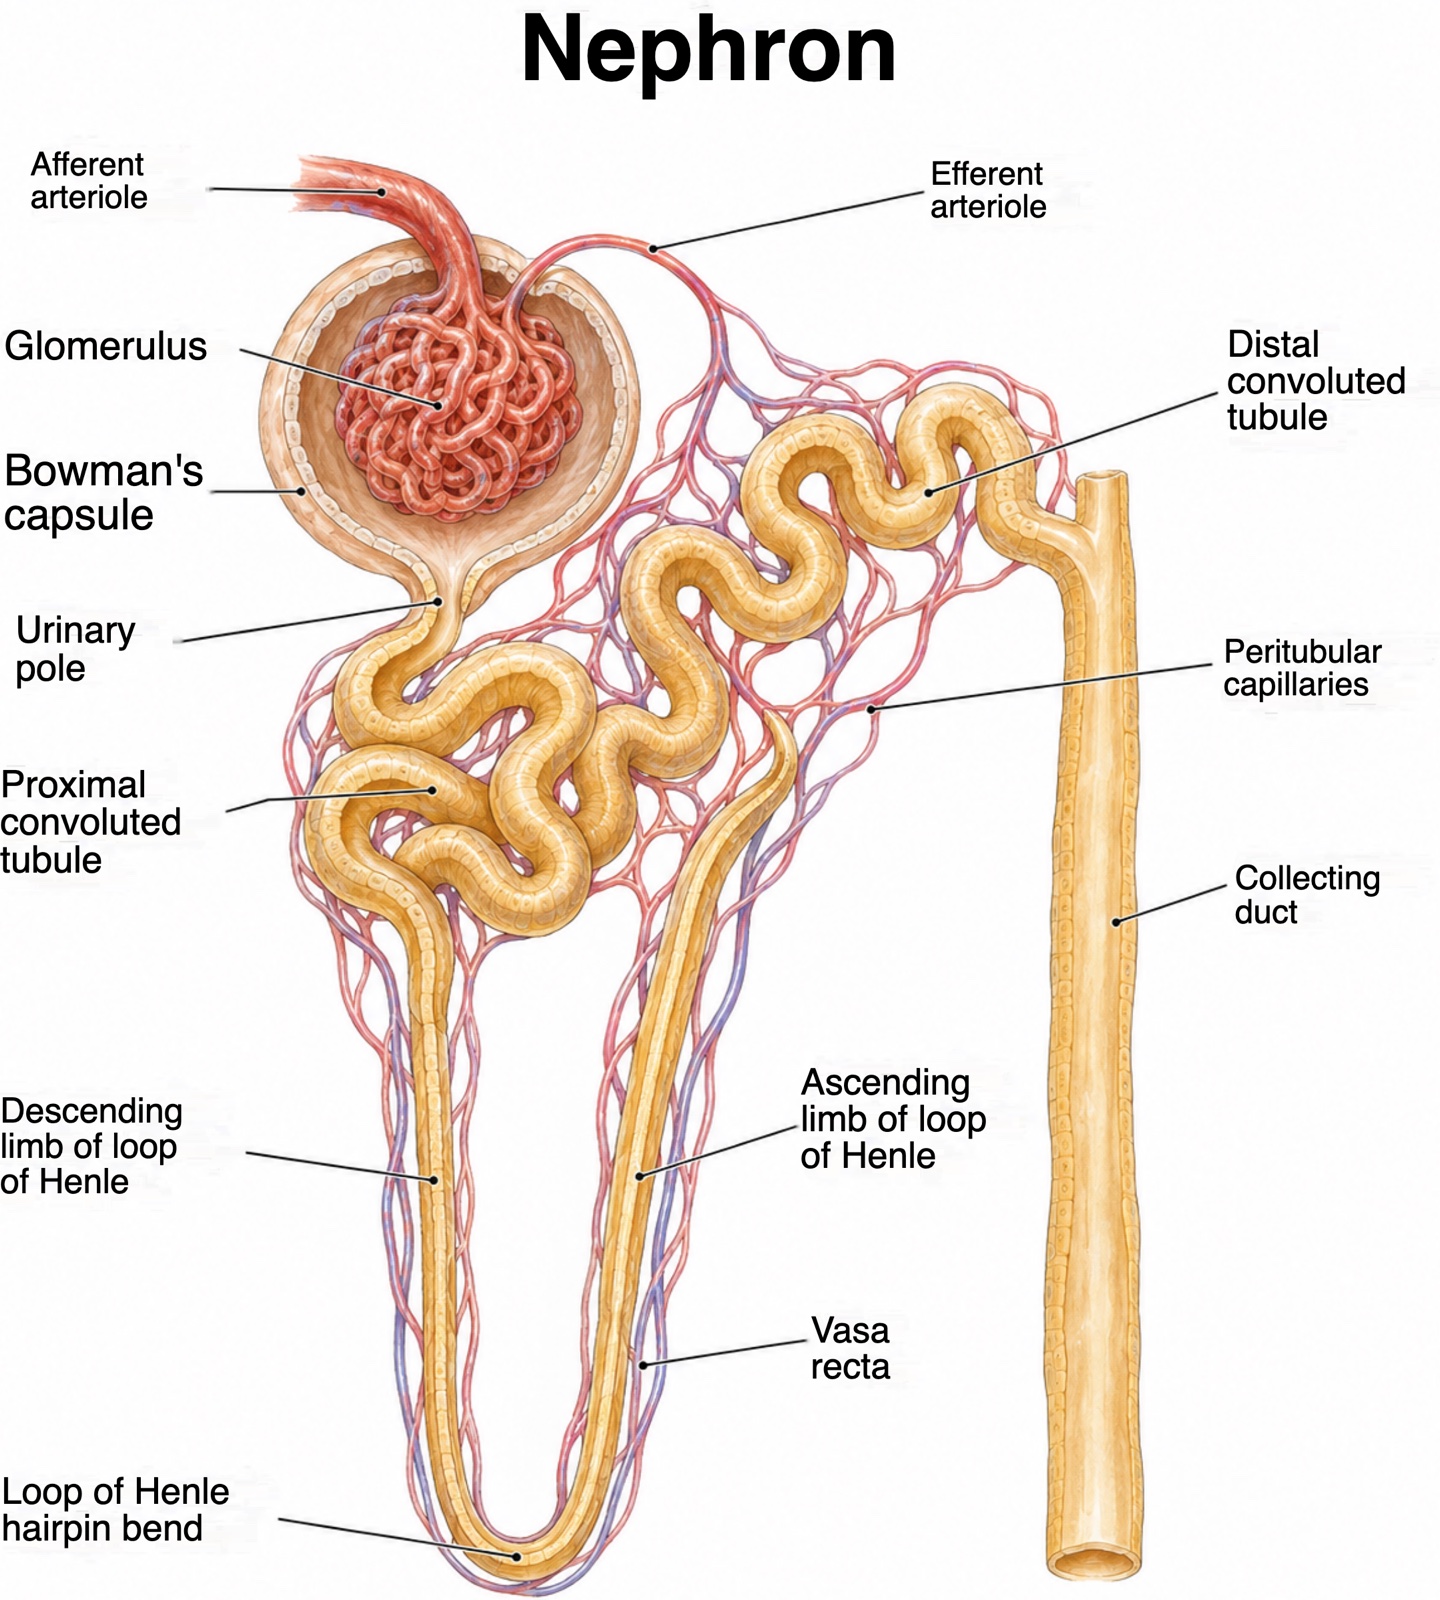
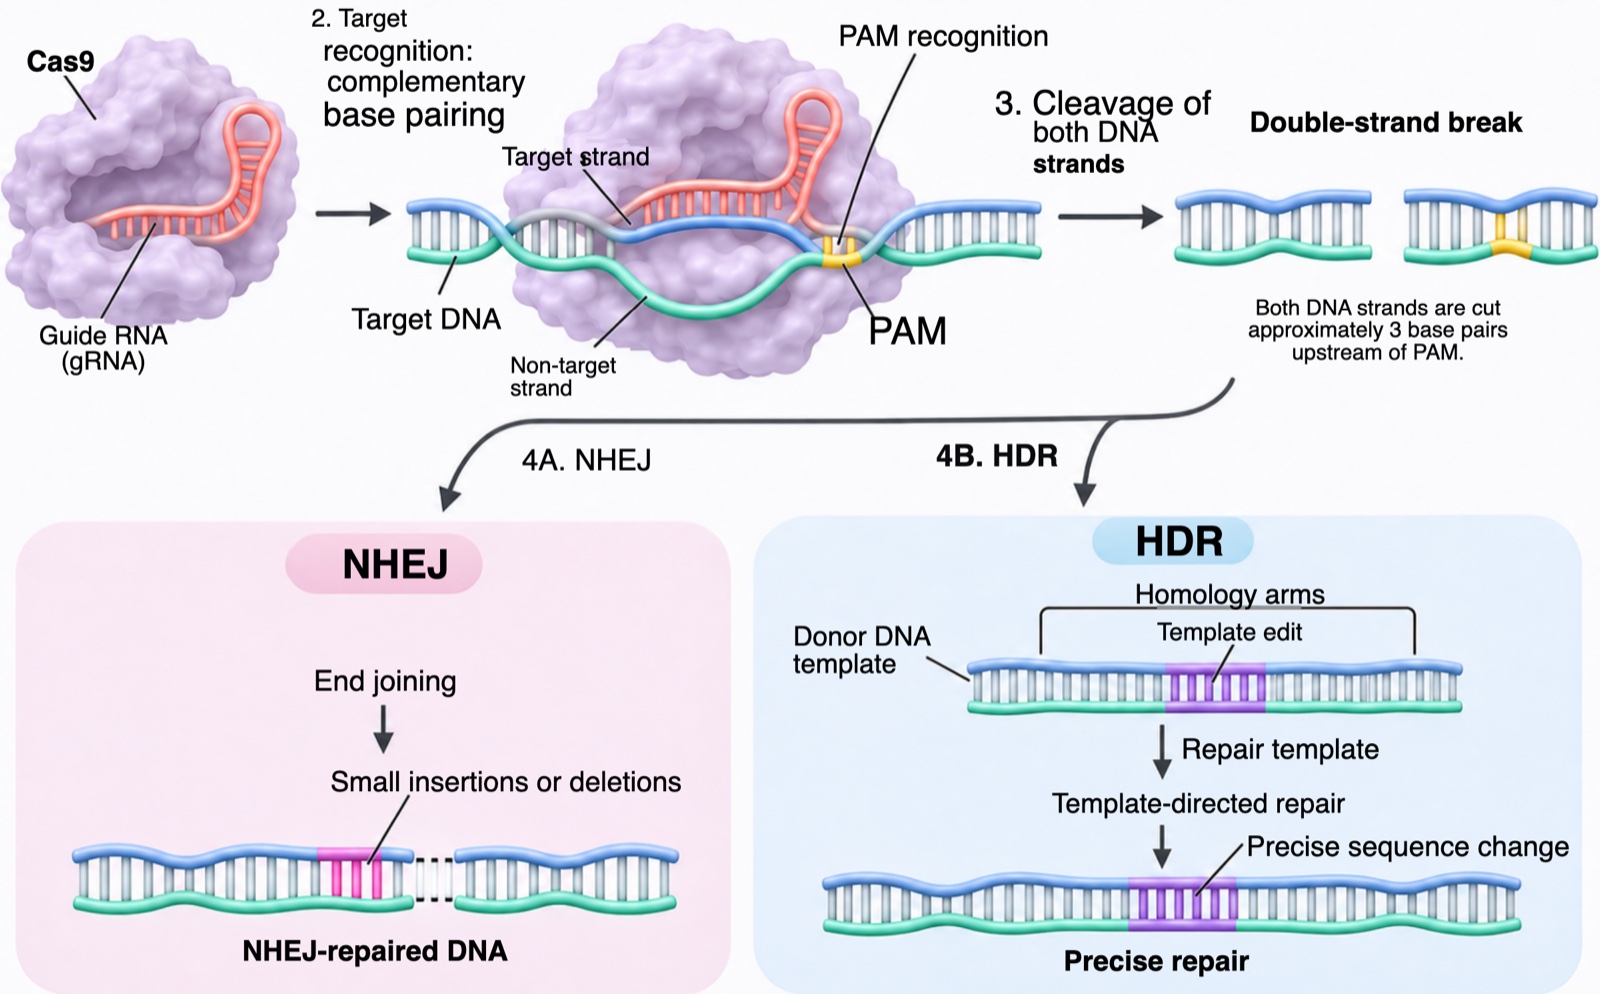
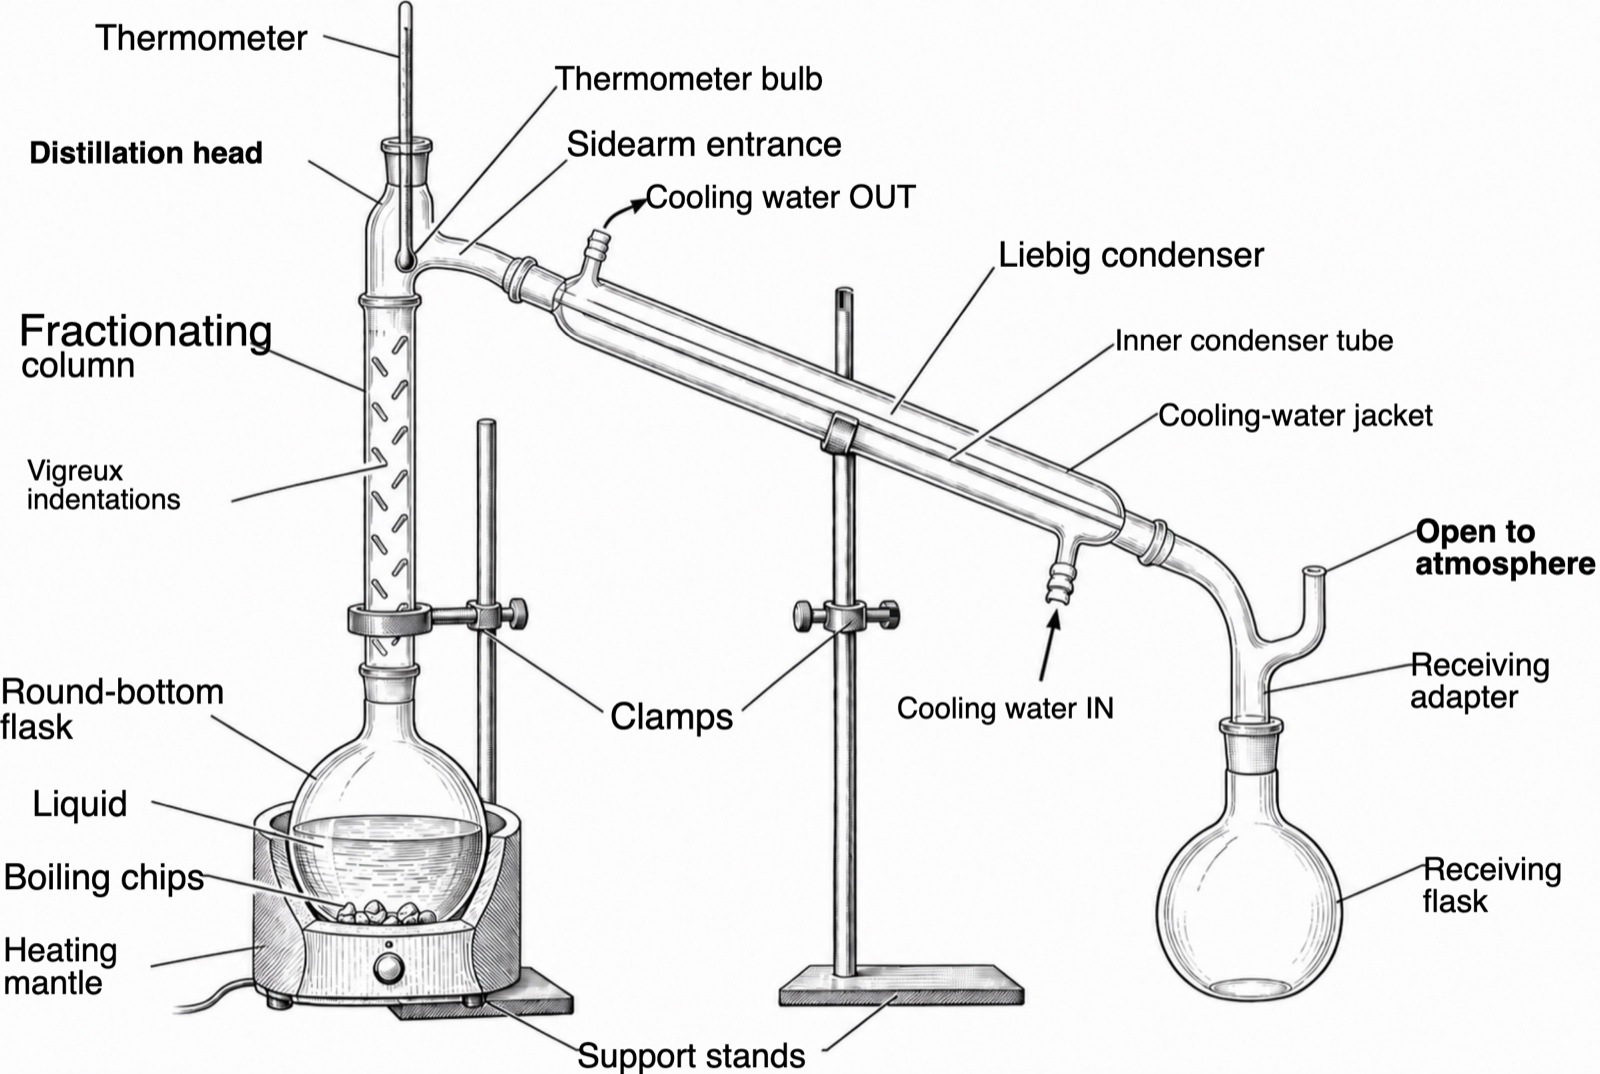
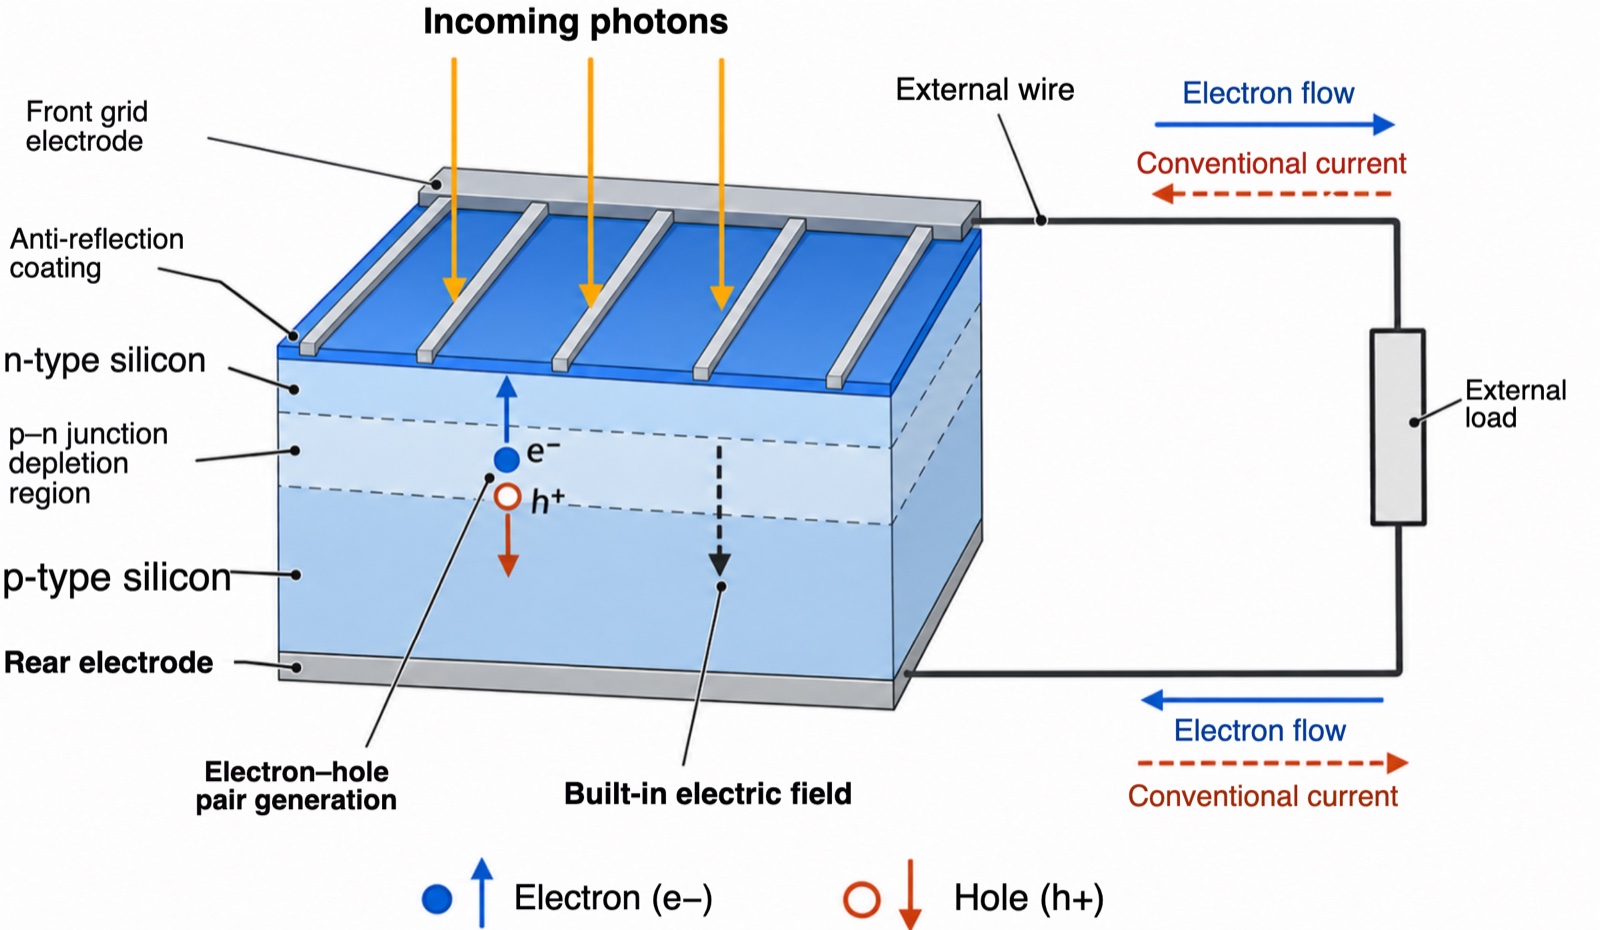
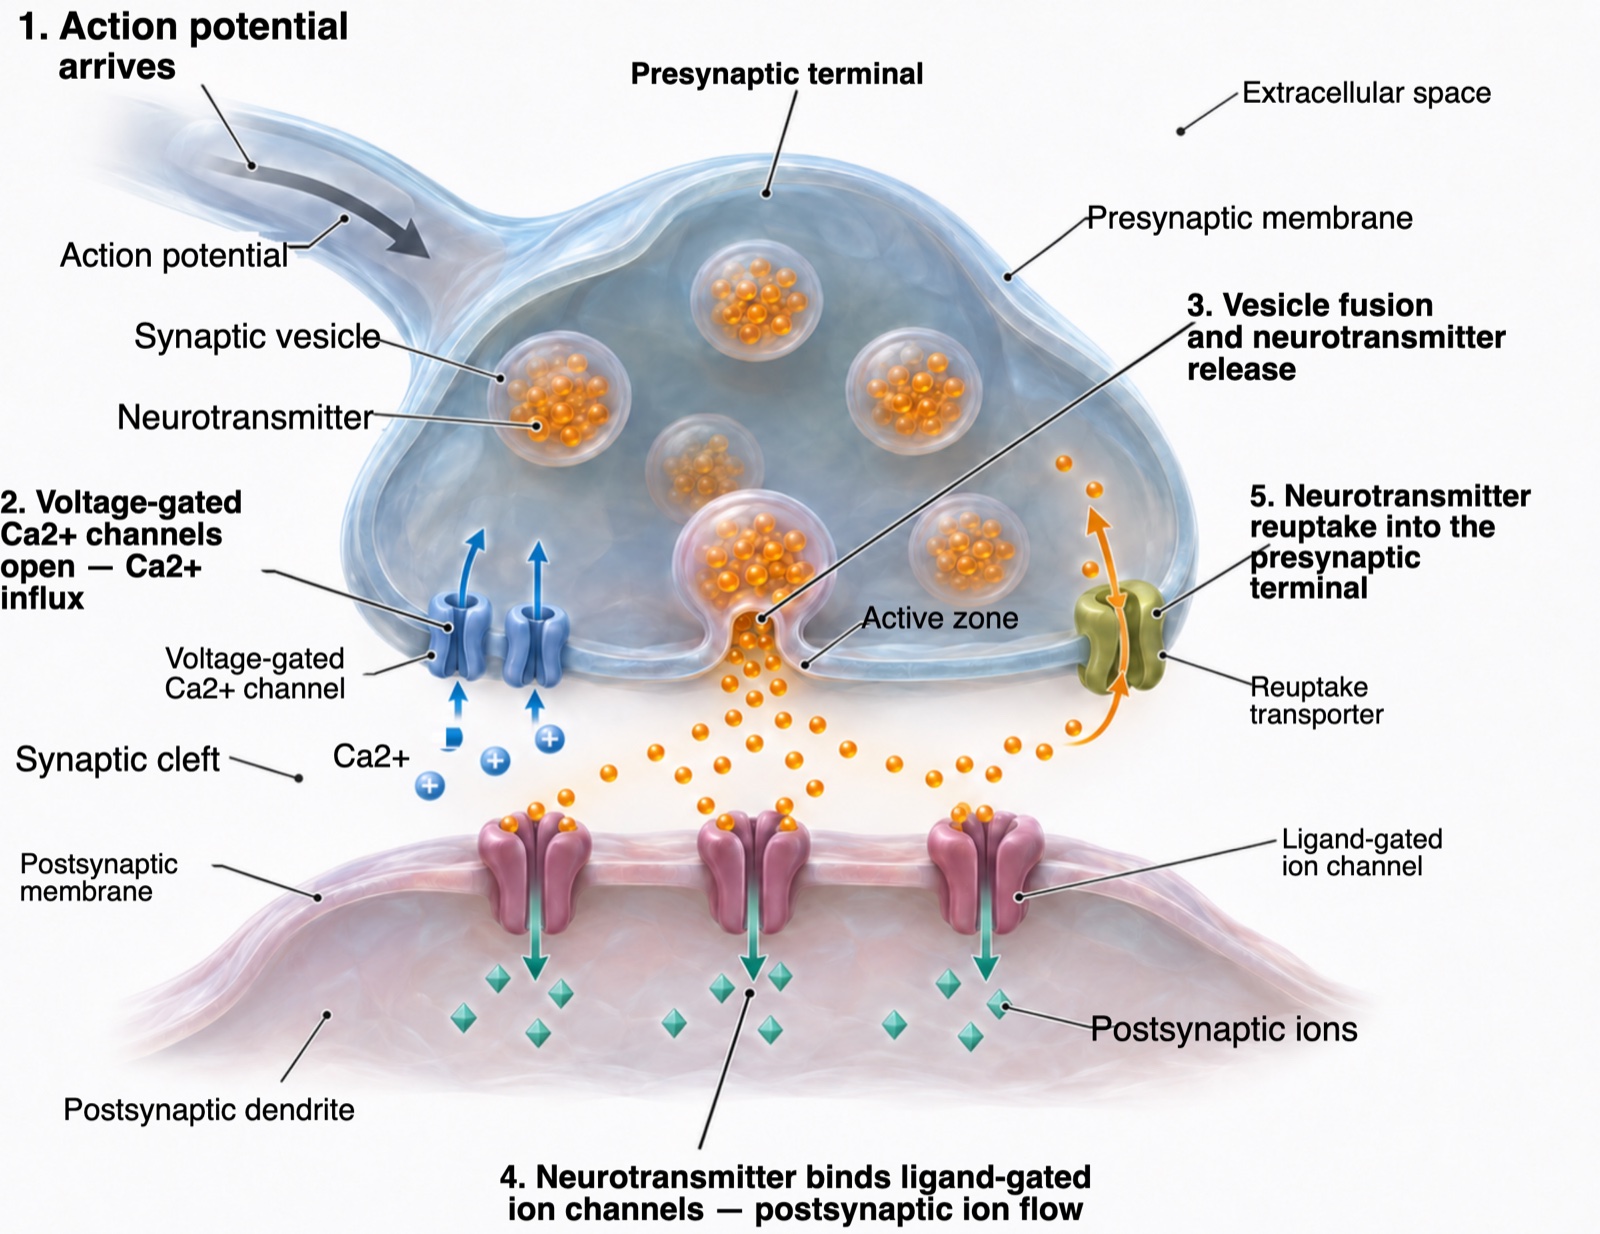
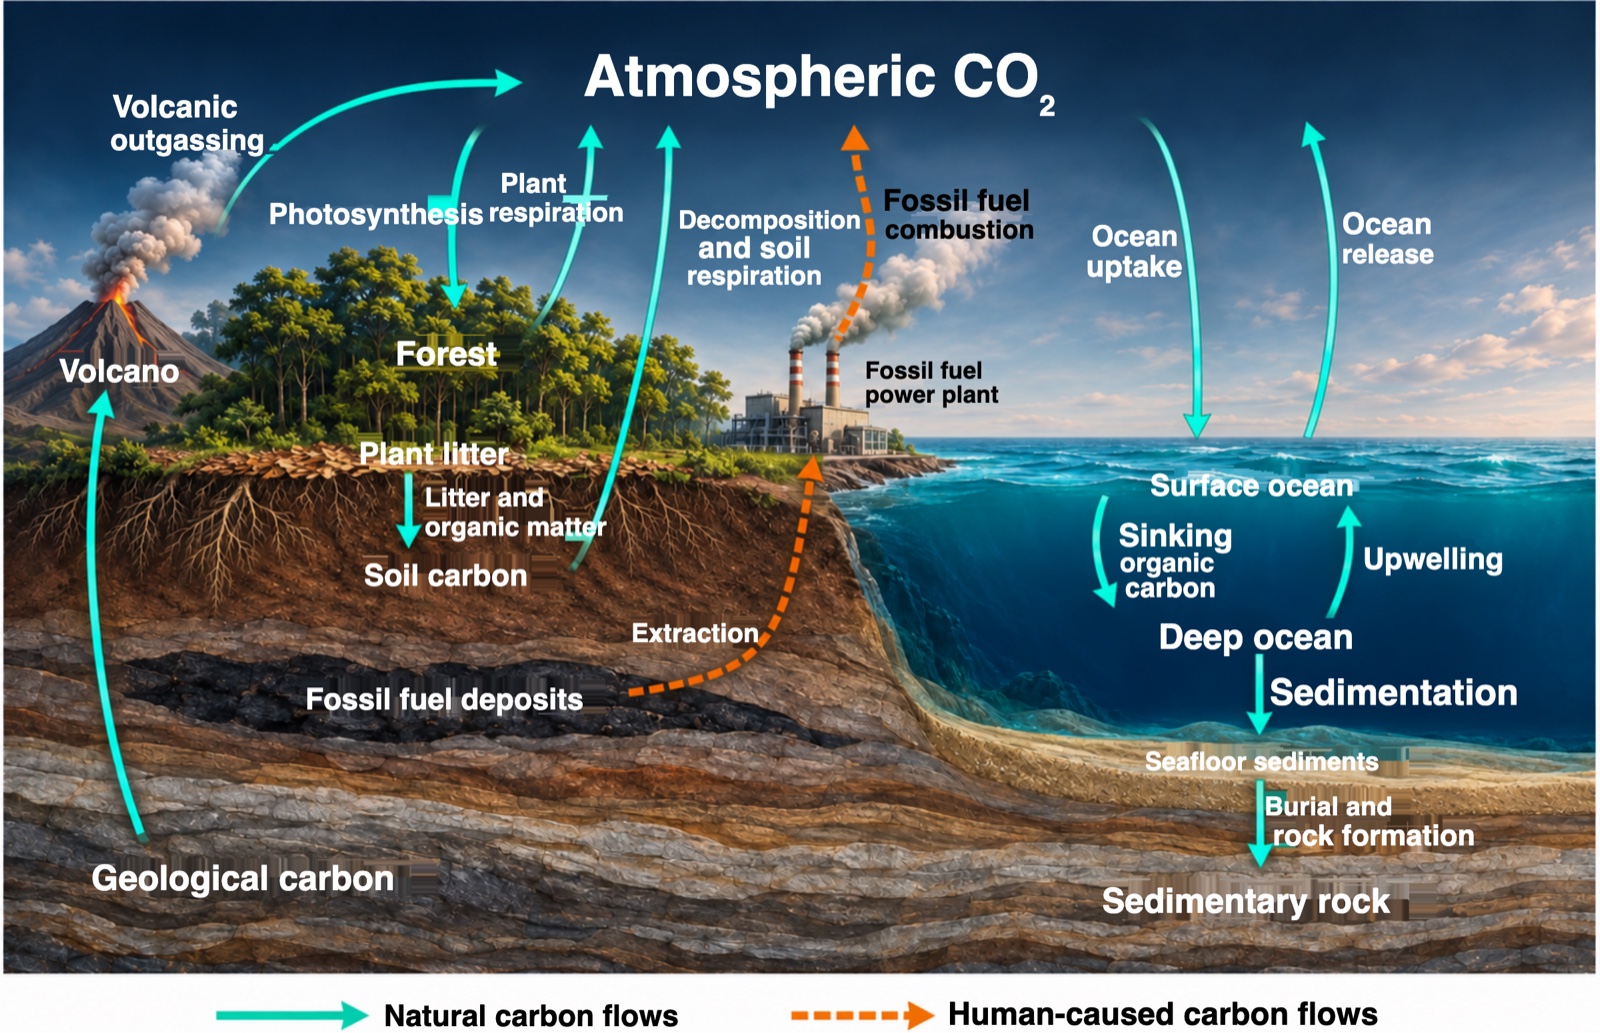
每一張都是測試版照一句話畫出來的,沒有手動修改。點一張可以放大。
匯入 CSV 或 Excel,用一句話叫它篩選、分組、畫圖或跑模型。它每一步做了什麼——讀哪張表、跑了哪段查詢、畫出哪張圖——都在旁邊一步步列出來,哪一步不對就退回那一步。
| species | island | bill_length_mm | bill_depth_mm | flipper_length_mm | body_mass_g | sex |
|---|---|---|---|---|---|---|
| Adelie | Torgersen | 39.1 | 18.7 | 181 | 3750 | male |
| Adelie | Torgersen | 39.5 | 17.4 | 186 | 3800 | female |
| Adelie | Torgersen | 40.3 | 18 | 195 | 3250 | female |
| Adelie | Torgersen | NA | NA | NA | NA | NA |
| Adelie | Torgersen | 36.7 | 19.3 | 193 | 3450 | female |
| Adelie | Torgersen | 39.3 | 20.6 | 190 | 3650 | male |
| Adelie | Torgersen | 38.9 | 17.8 | 181 | 3625 | female |
| Adelie | Torgersen | 39.2 | 19.6 | 195 | 4675 | male |
| Adelie | Torgersen | 34.1 | 18.1 | 193 | 3475 | NA |
| Adelie | Torgersen | 42 | 20.2 | 190 | 4250 | NA |
文獻庫、手寫筆記、舊簡報、寫到一半的稿子、資料,都不用重來。匯進來之後它們在同一張桌子上:AI 找得到,引用的每一句也都點得回原處。
整個文獻庫搬過來;用 RDF 匯出還會連 PDF 一起建索引,AI 找得到內文。
條目直接進文獻庫,寫作時 \cite 打得出來、引用會自己核對。
手寫筆記連 PDF 底一起進來,照原樣繼續寫;可以整個資料夾一次匯入。
筆跡變成可以擦、可以搜的手寫,跟你的論文和講義放在同一張桌上。
舊簡報逐頁轉成可以改的投影片;NotebookLM 匯出的 PDF 也行。
在真正的 docx 編輯器裡接著改,追蹤修訂和交叉引用都留著。
照原樣在 App 裡編譯;要交給 Overleaf 時匯出一份它直接打得開的。
貼一個連結,逐字稿和內容變成能引用、能點回原處的來源。
進資料表就能用一句話分析、畫圖,每一步都列在旁邊。
查資料、寫作、審稿、跑實驗、畫圖,各有各的記憶和專長。動手寫檔、跑程式之前先問你;工作的時候只在角落亮一圈光,不搶你正在看的畫面。
你正在讀第 3 章,@ 審稿人,他看的就是第 3 章,不用把內容再貼一次。
要跑程式、寫檔案,先跳一張允許卡;同一類的事可以勾「以後不用問」。
寫程式、跑實驗那一關交給它們,照樣經過我們的紀錄;用的是你的訂閱和額度。
把重的實驗交給另一台電腦上的助理,結果檔直接傳回你這台。
python train.py --seed {270001..270007}在行事曆拉一個時段,交給「查資料」或「跑實驗」的 agent:只做一次,或每週五早上八點。時間到它自己開工,做完的結果回到那一格。
每件工作都記著誰動過、交回了什麼;每天完成、失敗、等你看的件數一目了然。失敗的會停下來等你,不會一直重試。
跟教授開會、截止日都在同一週裡,進會議室前就知道 agent 會先備好什麼。
說一句你想研究什麼,聊清楚再開跑。判準、門檻和正式種子在看到結果之前就寫死;跑完自動判成立或不成立,事後不能偷改門檻。往下捲走過十關,或直接點一關。
AI 最容易出事的地方,是一條看起來很像真的引用。在這裡,每一條引用都要在你的文獻庫或公開索引裡找得到原文;找不到的,它擋下來,並且告訴你是哪一條。
因為遞迴要一步一步算,沒辦法平行;自注意力讓每個位置一次看到整段序列[2] p.5,代價是長度的平方。後來的稀疏注意力就是在降這個成本[7] p.2。
In this section we compare various aspects of self-attention layers to the recurrent and convolutional layers commonly used for mapping one variable-length sequence of symbol representations to another.
The amount of computation that can be parallelized, as measured by the minimum number of sequential operations required. A self-attention layer connects all positions with a constant number of sequentially executed operations, whereas a recurrent layer requires O(n) sequential operations.
同一張桌子也是你的讀書桌:英文課本、上課錄音、手寫筆記、作業和考試。它講給你聽的每一段,一樣連得回你自己的講義和筆記。
對照翻譯保留版面和公式;框一段問「這在說什麼」。
板書轉成可以擦掉的手寫;作業和考試範圍自動進你的待辦。
從講義和你的筆記生成解說影片、Podcast、字卡;每一段都標出它從哪裡來。
選擇、填空、計算、簡答;簡答照給分點批改。
字卡、測驗、心智圖、資料表、資訊圖,都從你自己的講義和筆記生成,每一項都標著出處那一頁。
電子傳遞鏈位在哪裡?
| 有氧呼吸 | 發酵 | |
|---|---|---|
| 在哪裡 | 粒線體(接在糖解之後) | 細胞質 |
| 要不要氧 | 要 | 不要 |
| ATP 產量 | 多 | 少 |
| 產物 | CO₂ 和水 | 乳酸,或酒精+CO₂ |
課堂錄音、你當下寫的那一筆、老師換到的那一張投影片,掛在同一條時間軸上。拖拖看:你的筆記會在你當時寫下它的那一刻重新寫出來。
拖動時間軸,或用方向鍵。點你寫的那個「∂」,錄音就跳回老師講鏈鎖律的那一句,投影片停在第 14 頁。
把論文、資料表、草稿拉到一張問題卡上,助理就讀得到它們;從回答裡挑一句,再從那一句問下去。
論文、錄音、未發表的數據,是你的研究,不是我們的訓練資料。
搜尋、筆記、排版、離線的語音與辨識模型都在本機跑;需要網路的只有雲端模型和同步。
實驗室和家裡各開著同一份稿,一台打的字幾十毫秒內出現在另一台。
批改連結、雲端備份都在你這邊加密,金鑰不經過我們;用量帳本裡沒有放得下提示詞的欄位。
送到雲端模型之前,先在你的電腦上去識別化:規則抓 Email、電話、身分證號、病歷號、日期、網址,本機模型認出人名、機構、地點。模型看到的是代號,回來的答案再換回原文。本機模型還沒準備好,就一個字都不送。可以整體開,也可以只對某一份文件開。
你的幾台電腦、一起寫的同學、改稿的教授,彼此直接連線。每一鍵都點對點同步;只有對方不在線上時才經過中繼,而中繼看不懂它轉送的內容。
實驗室和家裡開著同一份稿,一台打的字不到一秒就出現在另一台,直接在兩台之間傳。
邀同學一起改同一份 LaTeX、Typst、Markdown 或 Word 稿。邀請連結決定對方能改還是只能看、能碰哪個專案、多久到期,隨時可以撤銷。
傳一條連結,教授不用註冊。金鑰只在 # 後面,伺服器上一個字都看不懂;他改完回到你這邊是一條分支,要不要合併由你決定。
Pro 要兩邊同時開著才會同步。Pro+ 的修改會先在加密中繼等著:實驗室那台一開機就補上,同學半夜改的你早上也收得到。
功能兩種都一樣齊。差別在跨電腦、跟人一起寫的時候:Pro 要兩邊都在線上才同步;Pro+ 讓對方關機時修改照樣送到、教授有一個月慢慢批改,而且全部有雲端備份。
| ProUS$20/月年繳 US$200一台電腦為主,共編時大家都在線上 | Pro+US$40/月年繳 US$400實驗室加家裡兩台、跟同學長期共編、給教授批改 | |
|---|---|---|
| Pro+ 多的是這些 | ||
| 對方關機也收得到修改先在加密中繼等著,實驗室那台一開機就補上 | — | ✓ |
| 教授批改連結有效讓教授有時間慢慢看 | 7 天 | 30 天 |
| 加密雲端備份電腦壞了、掉了,論文還在 | — | 5 GB |
| 每月點數(官方 AI)兩倍多 | 150,000 | 320,000 |
| 表單回覆雲端保留 | 30 天 | 90 天 |
| 兩種方案都有 | ||
| 點對點同步、即時共編(兩邊都在線上時) | ✓ | ✓ |
| 全部功能:寫作、簡報、示意圖、資料、學習、研究助理 | ✓ | ✓ |
| 自備模型金鑰(BYOK) | ✓ | ✓ |
| 7 天免費試用 | ✓ | ✓ |
稅外加,結帳時顯示。年繳等於付 10 個月。點數包另購(US$10/45/160),買了 365 天內有效。沒有有效方案時 App 變唯讀,資料不會被刪。價格以結帳頁為準。
下載、登入,就能拿你自己的論文開始用。試用要先綁卡,第 8 天才扣款,在那之前取消不收費。
沒有方案時,你的資料不會被鎖住:App 照樣能開啟、搜尋、匯出和刪除。Mac 支援 Apple 晶片與 Intel;Windows 版即將上架 Microsoft Store。(雛形:按鈕還沒接到真的下載。)